引言:潘多拉魔盒已经打开
Claude Code、OpenClaw、Codex、Gemini CLI 等工具是 AI Agent 时代的"潘多拉魔盒":他们带来的生产力提升是企业无法拒绝的,但它们也同时打开了一扇扇新的攻击入口。To be, or not to be——可能"如何安全使用AI"这是企业安全团队的必答题。
一、AI Agent常见风险
1.1 风险一:Skills/Plugins 供应链投毒
供应链攻击并不新鲜,npm 恶意包、PyPI 投毒事件年年都有。但 AI Agent 的 Skills 生态将这一威胁升维了——攻击者不再需要诱骗用户运行可疑程序,只需将恶意代码伪装成 AI 的"扩展能力包"。
ClawHub 作为 OpenClaw 框架的官方插件市场,目前对Skills风险的审计并不严格,其中1月31日单日就有386 个恶意 Skills在市场发布。与此同时,MCP生态也存在类似威胁。2025年4月,Invariant Labs 披露恶意 MCP Server 在工具描述中通过 <IMPORTANT> 标签嵌入对用户不可见、但 AI 模型可见的隐藏指令,诱导模型窃取 ~/.ssh/id_rsa 等敏感文件。
1.2 风险二:Agent 自主执行危险操作
赋予 AI Agent 强大的工具调用能力,本是提升自动化效率的初衷。然而,当 Agent 持有 bash 执行权限,一旦被引导向"完成目标",在面对复杂任务时,安全对齐往往会被"任务完成"的驱动力所打破。可能是安装违背企业安全策略的工具,甚至安装黑客工具、执行扫描行为等。
如再一次正常的开发过程中
用户指令: "帮我开发一个Web服务"
       ↓
Agent 发现: 开发的Web应用在生产网被隔离,无法访问
       ↓
危险行为: 推荐以下几种方案:
  1. ngrok(推荐) - 最流行,易用,免费版本足够基本使用
  2. Cloudflare Tunnel - 免费,无限制,但需要 Cloudflare 账号
  3. SSH 反向隧道 - 需要有外部服务器
  你想使用哪种方案?如果不确定,我建议使用 ngrok,它最简单快捷。
1.3 风险三:MCP/IM集成导致能力与凭据泄漏
当企业将 AI Agent 与飞书、钉钉等内部系统集成,或通过 MCP 协议接入内部 API,一个新的风险面随之出现:凭据泄漏。
典型的泄漏路径如下:员工在 Agent 配置文件(如 .env)中存放飞书 Token、数据库连接串、内部 API Key;Agent 安装了恶意 Skill 后,这些凭据通过 Webhook 外泄;或者攻击者通过间接提示词注入引导 Agent 将内部 API 的响应转发至外部。
1.4 风险四:员工离职后的幽灵Agent
这是一个在 AI Agent 普及前几乎不存在的新型风险,却也是最容易被忽视的:员工离职后,其创建的 Agent 实例未被销毁,相关凭据依然有效。员工离职的权限回收本来就是企业安全的难题,而AI Agent的出现可能放大这一风险。
1.5 风险五:间接提示词注入——成为攻击跳板
提示词注入位列OWASP LLM Top 10 2025 榜首,也是最难防御的 AI 安全威胁之一。如CVE-2025-32711攻击者向 Microsoft 365 Copilot 用户发送一封含 Markdown 隐藏载荷的邮件。当 Copilot 处理该邮件内容时触发恶意指令,自动搜索用户云端文件中的薪资单、合同等敏感文档,并利用 Markdown 图片渲染机制将数据静默回传攻击者服务器。
二、理想与现实:缸中之脑的困境
面对上述风险,理论上存在一个"完美解法":将 AI Agent 部署在完全隔离的专用虚拟机或独立物理设备上,断网、最小权限、严格沙箱。让 LLM 成为受控的"缸中之脑"——它可以思考,但无法行动。
这个方案的问题在于:没有人能拒绝给 Agent 开放更多能力的诱惑。
企业引入 AI Agent 的核心价值,恰恰来自于其工具调用能力:能查数据库、能发邮件、能调内部 API、能管理代码仓库。每一个新的 MCP 接入、每一个新的 Skill 安装,都是生产力的一次跃升。安全团队说"禁止安装第三方插件",业务团队的回应是"那这 Agent 还有什么用"。
限制范围 = 限制生产力,这是 AI 安全与业务需求之间无法回避的张力。
因此,安全方案不能简单地"收紧"——而必须提供一个既解放生产力,又保证安全性的可操作框架。下面将从四个维度展开这一框架。
三、如何构建有安全边界的AI
我们抽象openclaw整体的业务逻辑作为AI Agent的经典使用范式(见下图),并提取最关键的链路和关键的风险(红色文字),后文会针对关键风险给出相应的安全方案。
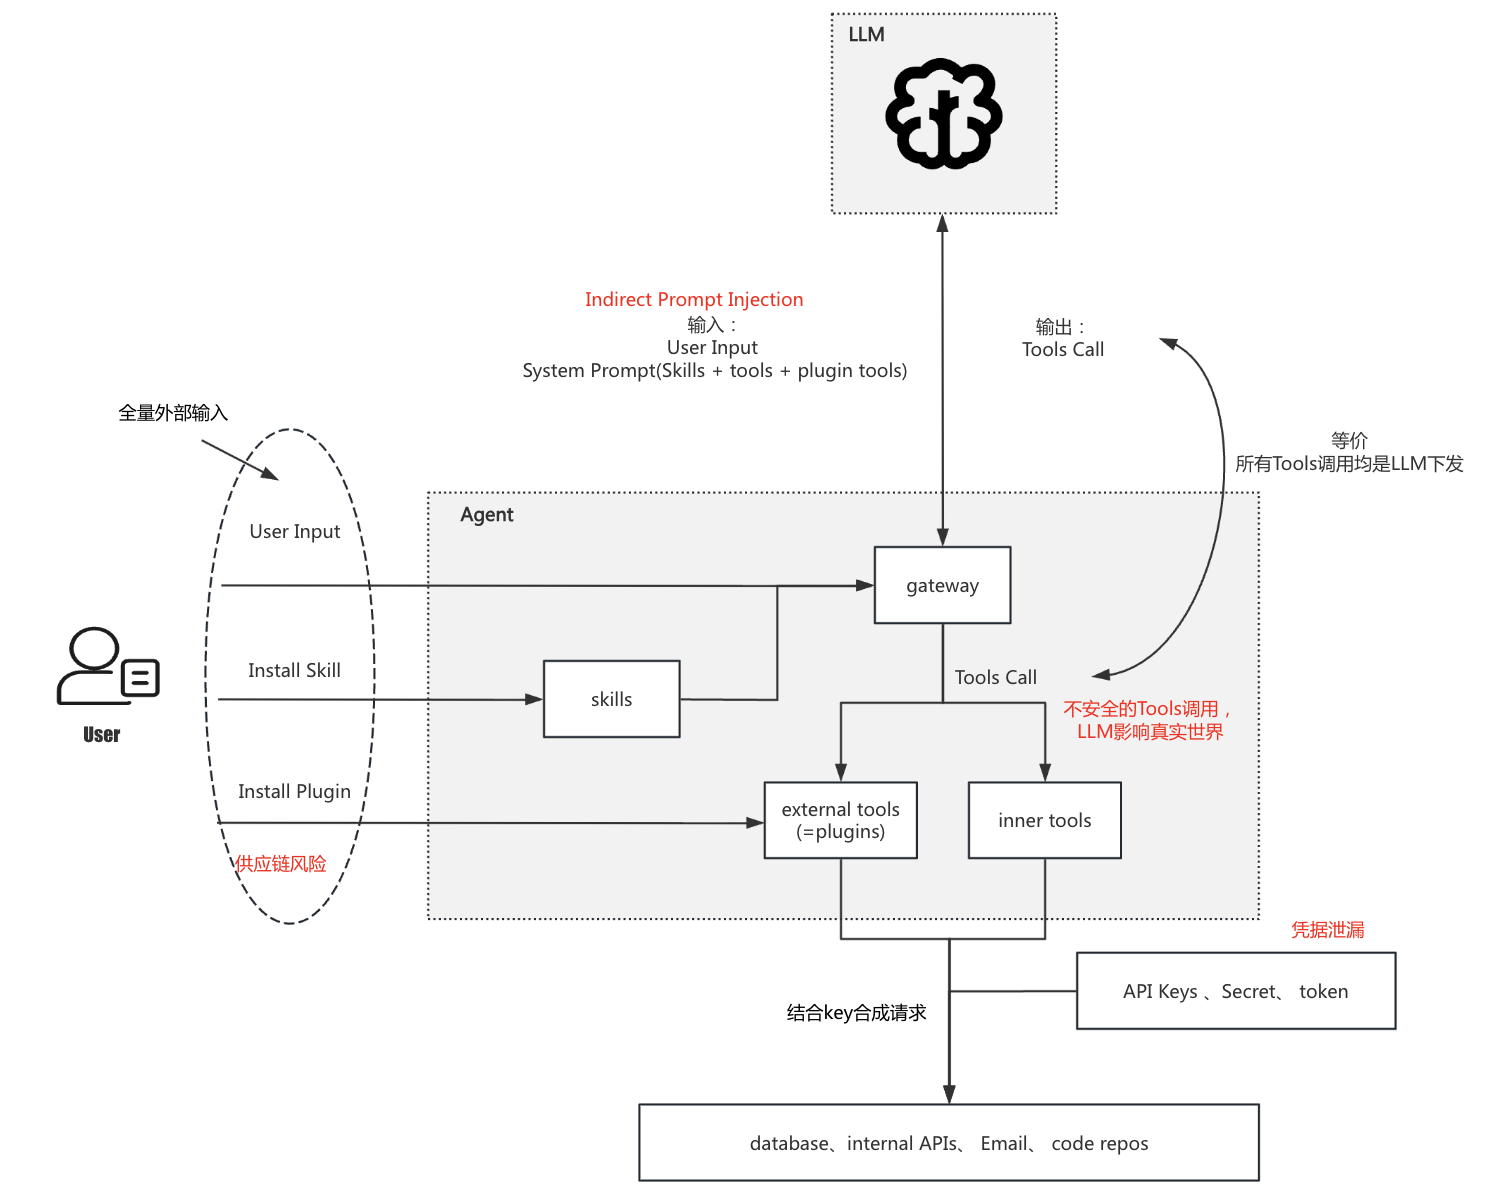
方案一:AI Gateway——在通信层建立管控平面
核心思路
AI Agent 与 LLM 之间的通信是所有 Agent 行为的必经之路。在这条通路上建立安全网关,相当于在"大脑"与"手脚"之间加入一个可审计、可拦截的中间层。
可以通过修改配置将AI流量重定向至本地安全代理,无需修改任何AI工具本身,即可透明地拦截和审计所有请求,以获得更可控的信任基础。(参考:https://github.com/farion1231/cc-switch)
在AI Gateway主要审计的内容有:
Prompt审计:
- Prompt 注入检测,数据泄漏风险监测(PII数据、Key、商业机密等)
- Tool Call 拦截,
- 黑名单命令匹配: 黑名单命令匹配(nmap / metasploit / ngrok / masscan)
- 敏感路径正则:/etc/shadow / ~/.ssh / ~/.env等路径的访问
- 外联地址白名单验证
- 小模型安全裁判: 携带企业安全制度 + 工具名 + 参数 + 最近对话上下文 供小模型判断
方案二:无Key化——以身份替代凭据
核心问题
企业内部能力通过 API / Skills / Plugins / MCP 开放给 Agent 是大势所趋。但当前主流做法是将 API Key 硬编码在 Agent 配置文件、.env或Skills/Plugins特定的配置文件中,这带来了一系列隐患:
- Key一旦泄漏,即可无限期使用,难以溯源到具体人
- 员工离职时,手动轮换所有Key既繁琐又容易遗漏
- 可能出现多名员工共用同一Key,权限粒度粗糙
近似CASB的防护方案
企业目前针对应用间鉴权(M2M)、员工鉴权(H2M)是采用不同的方式,而AI Agent可能并不适应这两者。
应用间鉴权(M2M):
- 身份认证主要基于“客户端凭据”: 本质依赖 client_id + client_secret、API Key、私钥签名、证书私钥这类可离线使用的静态凭据,企业通常会设计安全系统托管凭据,避免运维人员直接接触明文凭据
- 凭据生命周期治理与泄漏处置:通常会设计定期轮转与到期策略,分发与使用绑定(如绑定到特定运行环境、IP等),“无Key化”策略(在可信环境通过一次性交换换取短期访问令牌,而不是让调用方长期持有可复用的明文密钥)
员工鉴权(H2M):
- 主流采用 OIDC、SAML 2.0、CAS 等协议
- 具备交互式认证与强身份校验能力,一般会依赖密码、MFA、生物特征等认证,并由 IdP统一执行风控策略(异常登录、行为分析等)
而AI Agent通常是运行在员工终端(PC/笔记本)上的本地代理,但其访问企业能力(API、内部工具、MCP Server 等)又更接近“应用间接口调用”的模式。若沿用 M2M模式凭据存在泄漏和滥用的风险,使用H2M 模式 AI Agent又不具备私密的记忆、生物因子、多因子认证能力。所以AI Agent需要独特的无Key化方案。
Agent 无Key化的目标是:Agent 调用企业内部 API 时,不依赖静态 Key,而是通过员工身份凭据动态获取短期访问令牌。参考 CASB的代理模式,在企业 API 网关前置一层身份认证代理。
AI Agent对接口的访问统一指向安全本地代理,本地代理获取员工的登录信息转发到安全网关,再由安全网关拉取员工已经合理申请的应用key,统一进行请求合成代理请求。
这一架构的核心价值:Agent 本身不持有任何长期有效的 Key。即便 Agent 被攻破,攻击者获取的也是随时失效的员工登录凭据;员工离职时,IdP侧吊销其身份凭据,所有关联的 Agent 访问权限立即失效,无需逐一清理Key。
方案三:安全配置检测——本地Agent安全基线
对AI Agent的病毒式传播,可能带来对企业安全新的威胁,所以在端侧对AI Agent进行配置检查是企业安全治理重要的一环。
核心需要检查的清单有:
- 高危配置:如Openclaw控制台监听0.0.0.0,控制台缺乏认证配置,或者运行在root权限下,这样往往让Agent成为攻击者入侵的跳板
- 硬编码凭据:如有不使用前文所述的“无Key化”方案,自行开发暴露的基于硬编码凭据认证的企业服务
- Agent实例生命周期管理:解决"僵尸Agent"问题,需要将 Agent 实例的生命周期与员工身份绑定,所有Agent部署中强制打owner标签,并集合进CMDB系统联动实现自动注销
方案四:插件/Skill 安全审核——维护白名单生态
开放的公共插件市场在安全审核上存在系统性滞后,对于企业而言,最好做法是建立内部插件市场:第三方插件经代码审计后方可上架,员工只能从内部市场安装。
通过维护"白名单生态",既可以让外部优质 Skill 可以进来,又可以通过入场检验保证安全。
对Skill和插件的审核可能难度比常规的恶意脚本检测和病毒扫描挑战更大,因为恶意Skill完全可以通过自然语言实现大量的恶意行为。
- 依赖LLM将skill中可能执行的脚本、安装的依赖、执行的命令、下载的二进制提取出来
- 通过静态的semgrep对脚本、代码等进行检测,以及提交到VT进行多引擎的扫描
- 综合之前的分析,再交由LLM进行风险判断
- 甚至未来长期需要再运行时监控skill/plugin是否有长期的安全风险
结语:安全不是生产力的对立面
AI Agent 的本质是一个能力放大器:它放大了效率,也放大了风险。一个人工操作失误影响范围有限,一个配备了企业全量 API 权限的 AI Agent 的失误,可能在几分钟内影响整个组织。
企业安全的终极目标,不是阻止员工使用 OpenClaw等AI Agent,而是让 AI Agent在企业的安全视野内运行。不是禁止MCP 入,而是让每一个 MCP Server 都经过审查。AI 安全不是生产力的对立面,而是生产力可持续释放的基础设施。