承接前面的《阿里经济体生产网威胁检测实战》,详细展开一些在生产网检测时比较有效的检测方案。
Web攻击利用成功检测
主要针对全量的Web流量进行离线分析,解决定位比较关键的攻击成功事件,只有攻击成功的事件才有深度调查和分析的价值。
通过攻击的request和响应的response关联,当异常攻击特征检测规则命中的请求,能够关联到漏洞利用成功的特征则可以判断Web漏洞利用成功。这些才是入侵检测中需要响应的高危case。通常Web漏洞利用成功特征有:
- 漏洞的报错信息:如sql注入报错信息等
- 信息泄漏:ak信息泄漏、设备(/etc/passwd等)信息采集
- 常见框架利用成功特征: jenkins、Elasticsearch、weblogic等
- 攻击目标达成: 如命令执行返回
request和response的特征覆盖依赖于长期对攻击流量的清洗和对入侵事件的复盘。其中对海量的http流量做大规模的正则匹配基本无法通过串行的正则匹配解决,需要通过AC自动机实现多模匹配。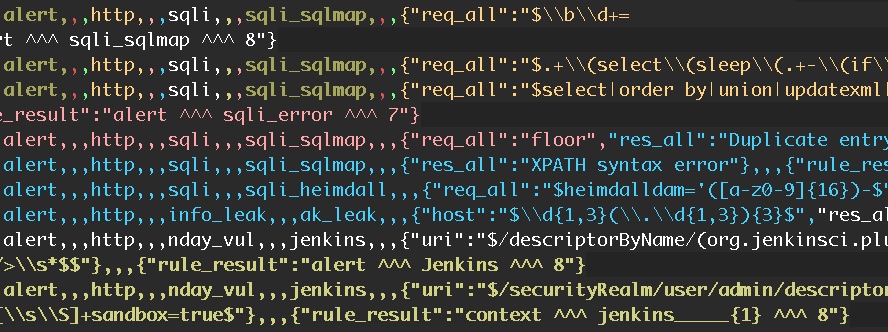
在Web攻击场景,repsonse的特征通常比较有效,而攻击payload往往会经过各种转义和变形,逃逸检测。
如
Runtime.getRuntime().exec("whoami").text
可以变形为
("Run"+"time").getRuntime().exec("who"+"ami").text
Class.forName("java.la"+"ng.Runtime").getRuntime().exec("whoami").text
Runtime."${'get' + 'Runtime'}"().exec("whoami").text
针对这类case,语义的检测思路比较有效。结合AST树还原攻击payload,一方面提升检测效果,对抗绕过手段,一方面可以提取真实攻击payload,构造有效的response特征。但AST树解析过程中,经常遇到利用边界分隔符进行上下文逃逸的,导致只存在部分代码片段可以进行检测。如:
groovy通过双引号闭合字符串
" + "whoami".execute().text + "
本质上攻击时会利用各种不同的边界分隔符、控制符号来达到闭合之前语句,执行注入代码,而由于之前的代码不完整,导致AST树解析失败。所以我们需要整理各编程语言可能的闭合手法,在构建AST树时兼容该手法,将其纳入词法分析和语法解析。
以antlr4举例:
在该场景,针对闭合手法,词法分析可以识别出如下规则可以匹配字符串闭合的Token
UNCLOSED_STRING
    :  '"' StringCharacter*
    |  StringCharacter* '"'
    ;

在语法解析层面,UNCLOSED_STRING等效于字符串
stringLiteral
    : StringLiteral
    | UNCLOSED_STRING    // ← 接受未闭合字符串
    ;
所以整体AST树的构建流程,遇到语法解析错误时,开始遍历是否有闭合字符,将闭合字符纳入词法解析。然后重新分析闭合字符的Token是否符合语法解析。
一些语言的闭合方式如下:
Groovy闭合方式
1. 字符串引号闭合
';"id".execute().text;'
";"id".execute().text;"
';"id".execute().text;'

2. 注释符号闭合
*/def cmd = "whoami".execute()/*

3. 二元操作符闭合
+Runtime.getRuntime().exec("whoami")+

4. 分号/语句分隔符
;Runtime.getRuntime().exec("whoami");

5. 方法引用/属性访问闭合
.'whoami'.execute()
Shell命令闭合方式
1. 分号闭合
;Runtime.getRuntime().exec("whoami");

2. 管道符闭合
|whoami

3. 逻辑闭合
&&whoami&&
||whoami

4. 引号闭合
';whoami;'
解决了闭合问题,接下来需要结合常量折叠和变量传递一些方式来对抗攻击逃逸香味。
如在遍历AST树时,需要将可以计算的常量进行归并计算,以对抗字符串拼接的场景。
(("who"+"am")+"i").execute()
可以通过后续遍历将字符串拼接操作进行计算。同时如果该语言有字符串处理函数如reverse、base64也可以进行基础的字符串处理。
针对块内 (Intra-block,没有控制流跳转)的代码块,可以通过遍历维护一个变量列表用于解决变量传递对抗混淆问题。
c = "who"
cmd = c + "ami"
cmd.execute()
在中序遍历AST树时,维护一个变量字典,用于存储变量名和变量值,在遇到变量时进行变量替换。其中shell有可能利用空变量来达到绕过的目的。
最后是匹配攻击模式,本质上是遍历生成的AST树,判断是否存在匹配可疑的代码行为的语法结构。
数据库日志白基线
这个主要解决入侵检测中的兜底。
从攻击动机上看:攻击目标的最终目的往往是针对数据库的数据窃取和勒索。
从覆盖上看:无论是Web端、移动端、数据同步平台、数据管理平台,或者攻击者通过账号密码直接连接数据库,最终针对数据库的操作都会记录数据库日志所以从数据库审计日志切入检测是目前覆盖面最全的。
从检测效果上看:数据库日志有一个特点,它一般是由开发编码好固定的查询语句,尤其绝大多数应用会硬编码带占位符的SQL模版,然后将SQL结合变量进行预编译然后执行。那么如果通过解析语义,尝试还原去除变量的SQL语句,就可以获取原始的SQL模版,而一个应用基于业务逻辑生成的SQL模版必然是有限的,所以可以尝试通过基线的逻辑来发现异常。尤其是配置数据库日志的来源应用、来源IP、使用账号等信息增强后。所以数据库日志白基线纯净度很高,可以准确发现异常告警。
具体实现:
一个SQL语句通常由关键字(Keyword)、标识符(Identifier)、函数(Function)、运算符(Operator)、字面量(Literal)、分隔符(Delimiter)、注释(Comment)组成,那么我们可以尝试分两个方式提取基线。
如下仅去除SQL中字面量(Literal)以及注释(Comment),在生产网环境中就可以构建基线覆盖大多数的SQL,通常取两周的业务流量就可以得到完整的数据库基线。
当然可以进一步仅保留SQL中的关键字(Keyword)、运算符(Operator),其中标识符(Identifier)等通过统计来抽象体现,这样提取的仅是SQL的基础框架,基线能更快速生成。
/*!40100 SET @@SQL_MODE='' */
select c,d,count(1) as cnt from abcd where a='abfdsafsac' and b>5 group by c,d;

提取模版:

select c,d,count(?) as cnt from abcd where a=? and b > ? group by c,d;
后续可以回溯常见的sqlmap信息搜集、mysqldump操作、数据窃取操作、sql注入基本都能通过基线识别出来。
进程白基线
从生产网服务器的特点出发,生产网的服务大多是标准的业务,通过容器编排批量部署,上面跑的业务通常比较稳定,相应的网络请求也有固定的范围,这是一个天然适配通过基线来实现异常检测的场景。
例如获取进程日志,可以很快训练出来对应应用正常情况下会运行的进程列表。但服务端进程日志,会有些路径是随机的问题,有些是容器导致的,有些是应用开发定义的,这些日志如果没发归一化来构建profile,可能基线也是没法运行的。
如:
/var/lib/docker/overlay2/c2ff1e174b65ccd1c52f4d0ae851e4417d9db0b44da08511255767a665793aad/merged/app/proxy
/workspace/xvfb-run.02fxQY/Xauthority
/home/admin/prod/nbapp/v0.2.3/nb
我们会通过模式树归一化来解决这个问题
- 按“/”分段
将所有进程按路径分隔符 / 拆成若干段(segment),例如
/workspace/xvfb-run.02fxQY/Xauthority    → ["workspace", "xvfb-run.02fxQY",   "Xauthority"]
/var/lib/docker/overlay2/c2ff1e174b65ccd1c52f4d0ae851e4417d9db0b44da08511255767a665793aad/merged → [... "overlay2", "c2ff1e174b65ccd1c52f4d0ae851e4417d9db0b44da08511255767a665793aad", "merged" ...]
- 构建Trie(前缀树)
用一棵多叉树来保存所有分段后的路径,每个节点记录:
segmentName:如果是叶子节点可留空,内部节点是具体字符串或预留“*”
count:通过该节点的 URI 数量
children:下一层分段的节点集
- 统计同级分支数量
对每一个父节点,统计它的直接子节点数 n。
如果 n 较小(例如 ≤ 3),说明这些分支很可能是固定路径(如 app、info、status…),保留原样。
如果 n 超过阈值(如 ≥ 10),说明该层是一个典型的随机路径,需要将这一层“归一化”成一个随机路径节点。
- 参数层的正则推断
当某一层被判定为“随机路径”时,遍历该层下所有实际出现过的值样本,利用简单的“模式匹配”或“候选模板”检测:
- 数字序列:全部都是连续数字 → \d+
- 版本号:形如 v\d+(.\d+)* → v\d+(?:.\d+)*
- UUID:满足 8-4-4-4-12 的 hex + 连字符 → [0-9a-fA-F]{8}(?:-[0-9a-fA-F]{4}){3}-[0-9a-fA-F]{12}
- 字母数字混合:长度固定或可变 → [A-Za-z0-9]{…}
- sha256 hash: [0-9a-f]{64}
- fallback:如果上面都不匹配,可退化为 [^/]+
- 生成最终正则模板
遍历 Trie,遇到被标记的“随机路径”用 (?regex) 或 {name:regex}(或直接 regex)替换,拼回成完整正则:
通过模式树归一化,进程的白基线在生产网的落地就有了可行性。
/var/lib/docker/overlay2/[0-9a-f]{64}/merged/app/proxy
/core_app/[\w]{5,6}/work/
/home/admin/prod/nbapp/v\d+(?:\.\d+)*/nb